💡 この記事を単品で読みたい方へ
単品でのご購入は、こちらの 【note元記事ページ】 からお手続きをお願いします。
🌟 【当サイト限定】圧倒的にお得なサブスク! 🌟
月額メンバーシップにご登録いただくと、この記事はもちろん、
これから配信される最新記事も、過去の全記事も
すべて読み放題になります!
単品で複数買うよりも断然お得です👇
📝 元記事確認用フルタイトル
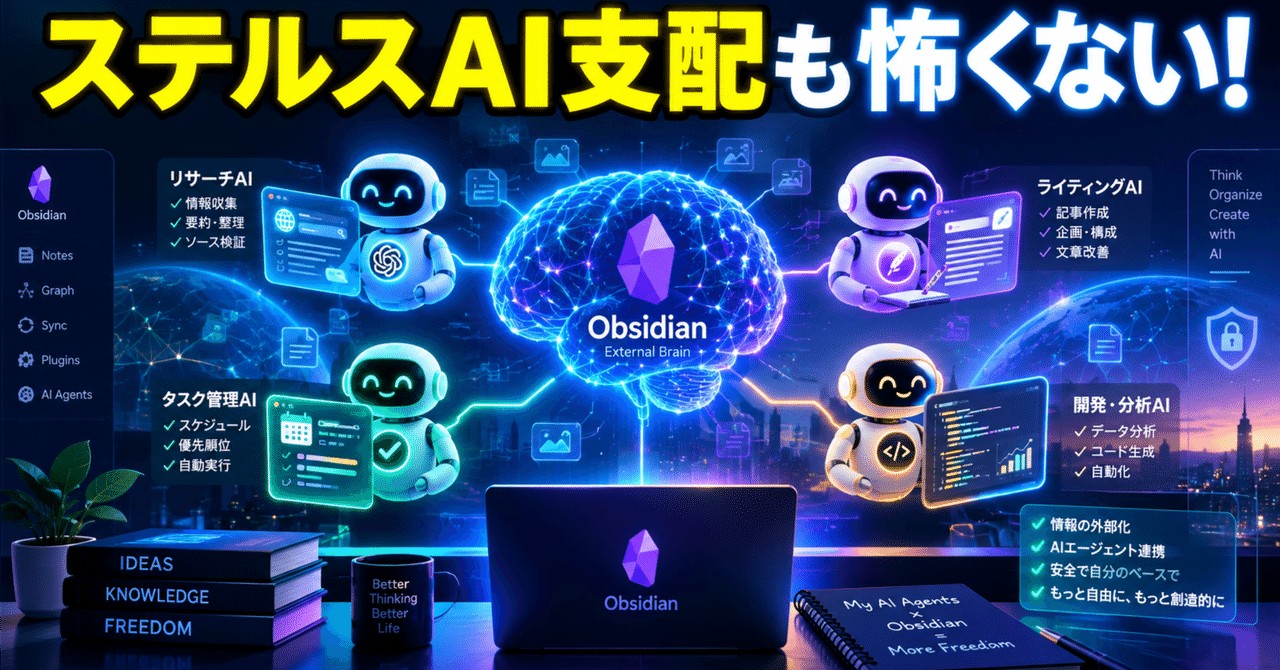
🚨ステルスAI支配も怖くない‼ AIに仕事を任せて気楽に生きる方法! ~ データ最小化でリスクゼロへ! 思考の整理はAI秘書にお任せ! ~😅
⬇️目次の読みたい項目をクリックしたらジャンプして読めます⬇️

ステルスAI時代における情報最小化とObsidian・ローカル外部脳×自律型AIエージェント活用戦略レポート

AIが解説します
※日本語をアメリカ人が話しているので漢字の読みをよく間違えます🙏
記事全体のAIエッセンス音声解説:
AIエッセンス・スライド解説:
AIエッセンス動画解説:
1. 序論:ステルスAI支配の脅威とパーソナルAIエージェントの台頭
AI技術の加速度的な進化に伴い、サイバー攻撃の自動化・高度化と個人・企業データの高度な探索・収集が進む「ステルスAI時代」が到来している。従来の境界型セキュリティや手動での脆弱性対応は限界を迎えており、個人や組織は「自社保有データの漏洩・不正侵入」と「高度AIによる自動攻撃」という二重のセキュリティ脅威に直面している。
同時に、知的生産の現場においては、人間がチャット画面から手動で指示を打ち込む段階を超え、背景知識(コンテキスト)を自律的に理解して行動する「パーソナルAIエージェント」が台頭している。この変化は単なる業務効率化にとどまらず、OpenAIのSam Altman氏が指摘するように、現代人が頭の中に常時抱え込んでいる「どうしようもない不安の塊(Overwhelming mountain of anxiety)」や未決定タスクの集積から人間を精神的に解放し、知的所有権と思考のゆとりを取り戻すという本質的な人間的価値をもたらす。この技術的・精神的パラダイムシフトに対応する戦略的活用基盤の設計こそが、個人および事業者の生存と競争力を左右する最重要課題である。
AI駆動型サイバー脅威の解剖
現在、サイバー脅威の性質はAIの進化によって根本的に構造変化を起こしている。
-
ゼロデイ脆弱性の自動探索と攻撃の自動化: Anthropic社のモデル「Claude」におけるセキュリティ特化型AI「Mythos(ミトス)」等に見られるように、最先端AIは人間が未だ発見していないゼロデイ脆弱性を自動的に探索・発見する能力を獲得した。これにより、従来は一部の高度なハッカー集団のみが可能だった攻撃が極めて容易かつ広範に実行可能となっている。
-
ダークウェブと暗号通貨取引による匿名化構造: 攻撃者はTelegramなどの匿名メッセージアプリを通じて連絡を取り合い、ビットコインをはじめとする暗号資産(暗号通貨)でデータ売買や攻撃ツールの決済を行う。このエコシステムにより、流出データの追跡や犯人の特定は極めて困難を極めている。
-
攻防におけるモデル構造の非対称性: 防御側が公式の最先端フロンティアモデル(クラウド型AI)を用いて自社システムの脆弱性診断を行おうとすると、モデル側のアライメント規制(安全審査機能)により「攻撃行為」と判定され、アカウントがBAN(停止)されるリスクを伴う。一方で攻撃側は、フロンティアモデル登場から半年程度遅れて流通する「オープンウェイトモデル(ローカル環境で動作可能な公開モデル)」を入手し、自身のPCやローカル環境で制約なく利用して攻撃手法を開発・実行する。防御側もまた、実効的な防衛体制を維持するために自前でオープンウェイトモデルをローカルで稼働させざるを得ないという、深刻な攻防の非対称構造が生じている。
パーソナルAIエージェント時代の到来と構造変化
AIとのインターフェースおよび運用構造は、数年単位で不可逆的なシフトを起こしている。
【ユーザーインターフェースとAI役割の変遷】
2022年〜:対話型チャット時代(Chat Operations / ChatGPT等)
  ↓ 一問一答型のテキストやり取り、プロンプト入力依存
2025年〜:コーディングエージェント時代(Coding Agents / 実装の自動化)
  ↓ コード生成や単一機能開発の自動実行
現在〜  :パーソナルエージェント時代(Personal Autonomous Agents / 24時間自律実行)
    ユーザーの文脈を記憶し、OS/アプリ全体を自律操作してタスクを完遂
かつての一問一答形式のチャットから、ユーザーのパーソナリティや過去の文脈を深く保持し、24時間365日体制でPC操作や業務実行を担う「パーソナルエージェント」へと主役が移行した。しかし、中央集権型のクラウド型AIに個人のあらゆる生活・業務ログを無差別に委ねることは、巨大プラットフォームによるデータ囲い込みや監視、一括漏洩のリスクを極限まで高める。自身のプライバシーとデータ主権を守りつつ、AIの知力を最大限に享受するためのアーキテクチャ再構築が不可欠である。
次章では、この高度化した脅威環境下で被害を最小限に抑えつつ法的な損害賠償責任を回避するための根本原則「情報最小化」と隔離型のセキュリティ設計について詳述する。
2. リスク回避の根本原則:「情報最小化」とデータ隔離セキュリティ設計
攻撃側がAIで武装した現代において、ネットワークの境界線で侵入を防ぐ従来の「境界型防御」は完全に崩壊している。システム内に機密データや個人情報を過剰に蓄積すること自体が、サイバー攻撃の格好の標的(攻撃対象領域)を生み出す最大の脆弱性となる。これに対する最も戦略的な防衛術が、自社システム内にクリティカルなデータを「持たない・保持しない」という**情報最小化(Data Minimization)**の徹底である。
自社データ保持リスクと責任転嫁(損害賠償回避)モデル
-
過剰データ保持の致命的リスク: 運転免許証の画像データ、顧客の個人情報、クレジットカード情報などのクリティカルデータをローカルや無防備な自社システムに保持することは、常にゼロデイ攻撃の脅威に晒され続けることを意味する。一度漏洩が発生すれば、企業としての信用失墜のみならず巨額の損害賠償責任を負うことになる。
-
クラウド委託による責任転嫁ロジック: 自社で危険なデータを直接保持せず、高度な防衛インフラを備えた大手クラウド事業者や専用サービスへ委託・非保持化を図る。自社内に実体データを置かない設計にすることで、万が一の攻撃時にも被害を最小化できる。さらに、委託先クラウドサービス側からの漏洩であれば、自社が直接的な管理過失責任を問われる事態を避け、被害者としてクラウド事業者側へ損害賠償を請求できる法的ポジションを保つことが可能となる。
アーキテクチャレベルでのデータ保護メカニズム分析
最新のパーソナルAI基盤では、ユーザーの利便性を損なわずに機密情報を保護する高度な隔離メカニズムが実装され始めている。
-
Meta Museにおける監視・隔離アーキテクチャ: ユーザーの代わりにタスクを実行するエージェント(Muse Spark等)と同一の仮想マシン(VM)内に、監視専用エージェント**「Sentinel(センチネル)」**を常駐させる構造をとる。エージェントが生成したコードや外部アクセスの動きは、Sentinelの厳格な許可がない限り外部インターネットへ出られない。さらに、利用者のデータは暗号化された仮想マシン(暗号化VM)に格納され、運用元であるMeta社自体もユーザーのデータや会話内容を閲覧できない仕組み(Zero-Knowledge志向)が構築されている。
-
Stripe Link等を活用した決済情報の非保持: 購買・契約タスクをAIエージェントに委託する際、本物のクレジットカード番号をAIモデルや取引先Webサイトに渡さない設計が取られている。Stripe Linkなどを通じて「使い捨てのカード番号(バーチャルカード)」を発行・伝送することで、万が一途中の通信や相手方システムで情報が盗み取られた場合でも、本物の決済情報が漏洩する事態を物理的に遮断している。
戦略比較表:データ保持モデル vs 情報最小化モデル

機密データを自社や無防備な環境から排して被害リスクを極小化する一方で、業務出力の精度を高めるにはAIへ与える「文脈(コンテキスト)」が不可欠となる。次章では、セキュリティを保ちながら高度な知力を引き出す「ローカルコンテキスト管理」のアーキテクチャを解説する。
3. ローカル外部脳(Obsidian/ローカルPC)へのコンテキスト蓄積アーキテクチャ
機密情報や個人データを無差別にクラウドAIへ投入できない環境下において、AIに高度で文脈に沿ったアウトプットを出力させるには、ユーザー固有のコンテキスト(背景情報・過去の思考・行動履歴)をローカル側で厳格に管理・蓄積する戦略が不可欠となる。自前のローカルPCやObsidianなどを活用した**「ローカル外部脳」**の構築がその中核を担う。
クラウドAIのコンテキスト限界とローカル管理の必然性
-
巨大コンテキスト投入の限界: 何十ギガバイトからテラバイト級に及ぶ膨大なコンテキスト(何年分もの音声録音データ、過去の提案書、対話ログなど)をそのままクラウド型AIモデルに常時投入しようとすると、莫大な通信・API利用コストが発生する。また、AIのコンテキストウィンドウが過負荷(パンク)を起こし、処理精度の大幅な低下やメモリ不足によるシステム停止を引き起こす。
-
独自の知見・履歴の「資産化」: 個人の思考パターン、過去のコンサルティング実績、サークルバック(Circleback)等で日常的に許可を得て録音・テキスト化した音声ログ、個人のスケジュール制約(例:「13時より前に予定を入れるのは禁止」等のルール)は、ローカルPCやObsidian内に整理してストックすることで、誰にも奪われない個人の知的資産となる。
AIの自己評価・自己改善ルーブリックのローカル蓄積
ローカル外部脳に蓄積すべきは、単なる過去の対話ログや文脈データにとどまらない。次世代の差別化における最重要テーマは、「AIが出力した成果物を自律的に採点・修正するための評価基準(自己改善用プロンプト・ルーブリック)」をローカル側へ持たせることにある。
AIが実行した結果に対し、「何をもって成功とするか」「どのような文章・コード構造が品質基準を満たしているか」の採点基準(ルーブリック)をローカルに蓄積しておくことで、AIは外部の指示を待たずに自己評価・自己改善ループ(自己修正プログラム)を自律的に回すことが可能となる。このルーブリック群こそが、モデル性能が平準化する時代における唯一無二の競合優位性となる。
【ローカル外部脳とクラウド実行エンジンの分離・自己改善アーキテクチャ】

 [ローカル環境(不変の集積脳&評価基盤)]           [クラウド環境(使い捨ての実行エンジン)]
+----------------------------------------+        +------------------------------------+
| ・Obsidian / ローカルストレージ        |        |                                    |
| ・過去ログ・音声データ・思考パターン   |        |  Claude Code / Codex / Astra等     |
| ・個人ルール(13時以降予定等)         |        |                                    |
| ・【自己改善用評価ルーブリック】       |        +------------------------------------+
+----------------------------------------+                          ^
                   |                                                |
        (自動インデックス・絞り込み)                                 |
                   |                                                |
                   v                                                |
   [コンテキスト・フィルタリングハブ] -------------------------------+
    ※必要な文脈と評価基準のみを抽出伝送(漏洩防止・品質自己改善)
ローカルコンテキストの自動整理とフィルタリング伝送システム
膨大なローカル外部脳から外部AIへ情報を渡す際は、セキュリティと処理効率を両立させるフィルタリング伝送メカニズムを構築する。
-
自動圧縮・整理とインデックス化: 日常会話、収集データ、音声ログをローカル内で自動整理し、検索可能な構造として維持する。
-
サーチ・絞り込み機能による伝送最適化: ユーザーがタスクを命じた際、ローカルハブ側で関連する過去のコンテキストおよび評価ルーブリックのみを自動検索・抽出(サーチ・絞り込み)する。外部AIへ渡すコンテキストを必要最小限に抑えることで、機密データの不用意な漏洩を防ぎ、処理速度を劇的に向上させる。
-
役割の完全分離設計: 外部のクラウドAI(Codex、Claude Code、Astra等)をいつでも差し替え可能な「使い捨ての実行エンジン」として位置付け、ローカル側のObsidianおよびPC群を「不変の集積脳(外部脳)」として分離・定義する。
ローカル環境に蓄積された高品質なコンテキストと評価基準を効率的に抽出し、実際の業務に展開するには、それを動かす「自律型AIエージェント」の適切な選定とタスク委任構造が鍵となる。次章では主要なエージェントシステムの特性を多角的に分析する。
4. 自律型AIエージェントの比較分析と業務実行戦略(dots、Muse、Grok Bot、自作ハーネス)
パーソナルエージェント時代において生産性を最大化するには、市場に存在する主要エージェントおよび自作システムの特性を理解し、業務の性質やセキュリティレベルに応じて最適なツールを選択・組み合わせる必要がある。
主要AIエージェントの多角的一括比較分析
1. dots(ドット)
OpenAIの「Astra」モデルをバックエンドに搭載し、クラウド上の仮想マシン(VM)で24時間連続稼働する自律型エージェント。
-
技術的強み: スクリーンショットの連続撮影に頼る従来のコンピューターユース(Computer Use)とは異なり、DOMへの直接アクセス、アクセシビリティ情報の読み取り、JavaScriptコード生成(Playwright等)を組み合わせて操作をバッチ実行するため、Webやアプリの操作が圧倒的に高速である。頼まれる前に自律的に気を利かせてメールの未返信を指摘するリラクティブ性を持つ。
-
課題・弱点: 1つのチャット窓にすべての命令を投入する「1窓型UI」を採用しているため、複数の重いタスク(開発、リサーチ、資料作成など)を並列処理させようとするとコンテキストが混同し、管理者が進行状況を監視しづらい。また、8個以上の高度なタスクを同時に動かすとメモリ消費量が100GBを超え、リソース不足により停止や処理の遅延が発生しやすい。月額コストも高額(約100〜500ドル規模)である。
2. Meta Muse(ミューズ)
Meta社が開発した、一般消費者からビジネス層までを幅広く対象とする個人向けエージェント。
-
技術的強み: 専用頭脳「Muse Spark」モデルで駆動し、専用端末「Muse Charm(タッチ画面、5G通信、前後カメラ、スピーカー等を備えた卵型デバイス)」やWhatsAppなどを通じて操作可能。前述のSentinelによる監視、暗号化VM、Stripe Linkによる使い捨て決済など、個人プライバシー保護に最も特化した安全設計を持つ。
-
課題・弱点・運用制限: 現状は米国・カナダ等での展開が先行している。また運用上の明確な制約として、Facebookメッセンジャー等の外部サービス巡回・監視において、相手方プラットフォーム側の制限やAPI制約により常時リアルタイム監視が行えず、1時間に1回程度のアクセス頻度に制限される点や、ブラウザを経由した常時オン監視に限界があるといった仕様上の課題が存在する。
3. Grok Bot
xAIの基盤上で動作し、非エンジニア層にも扱いやすい直感的な操作感を持つチーム運用型ボット。
-
技術的強み: 話題や業務ごとに複数のボット窓を独立して作成・管理する「チーム運用(多窓型)」に特化。「副編集長ボット」が配下の複数ボットに自動で指示を出して並列処理を完了させるような組織的運用が可能。また、自社モデルに固執せず、Claude Opus 5.5、Midjourney、Sunoなどタスクに最適な最先端他社モデルを裏側で柔軟に組み換えて処理を行う。
-
課題・弱点: 単体での高度なシステム開発や大規模コンテキストの直接保持・リサーチ能力においてはフロンティアモデル直接利用に比べやや劣る場合がある。
4. 自作ローカルハーネス(例:AI仙人「247」システム等)
LINEやDiscordなどの日常的なSNSをインターフェースとし、裏側でローカルPC群と最先端モデル(Codex、Claude Code等)を常時連携させるカスタムビルドシステム。
-
技術的強み: 168時間(24時間×7日)完全連続稼働を実現。ユーザーの過去の全対話・ルール・コンテキストが凝縮されたローカルPCと直結しており、LINE等で「提案書を作成して」「予定を教えて」と一言送るだけで、裏側の複数PCでCodexやClaude Codeが自律的に周回・コード実行・ファイル作成を行い、完成物をLINEへ返信する。人間と見分けがつかないレベルの自律性と、自己発展機能を備える。
-
課題・弱点: 構築・メンテナンスに高度な技術的知見が必要であり、裏側で動作するモデルの思案・処理時間によって返信までに一定の時間を要する場合がある。
エージェントシステム多角比較表

「単一秘書型」vs「複数専門チーム型」のタスク委任戦略
【タスク委任構造の対比】

[単一秘書型(dots等)]
 ユーザー ──> [ 単一チャット窓 ] ──>(全タスクを1つのコンテキストで自動振り分け)
              ※利点:シンプル、管理窓が1つ
              ※欠点:複雑タスクで文脈混同、重処理でリソースパンク

[複数専門チーム型(Grok Bot / 自作ハーネス等)]
 ユーザー ──> [ 副編集長 / 統括ボット ]
                    ├──> [ 開発担当ボット ] (Codex等)
                    ├──> [ リサーチ担当ボット ]
                    └──> [ 資料作成担当ボット ] (Claude Code等)
              ※利点:タスク隔離で精度安定、並列処理に強い
              ※欠点:管理する窓数・ボット設計の初期コスト
-
単一秘書型アプローチ: 1人の秘書にすべてを任せる思想。全知全能のコンテキストを1窓に集約するため、命令がシンプルで初心者には扱いやすいが、実務で8個以上のプロジェクトを同時並行させるような高負荷環境では、文脈の混ざりやメモリパンク(100GB超の消費)を引き起こす。
-
複数専門チーム型アプローチ: 業務・コンテキストごとにボットの窓を独立させ(例:8体〜30体)、統括ボット(副編集長)が各専門ボットへタスクを割り振る思想。話題ごとに文脈が完全に隔離されるため、大規模な新規事業開発、リサーチ、コンサルティングなど、複雑かつ多重な業務をミスなく並列実行させる戦略において極めて高いパフォーマンスを発揮する。
比較分析を踏まえ、最終章では個人や組織が直ちに実行に移すべき段階的ロードマップと、AIと融合することで個人の知力を解放する楽観的未来戦略を示す。
5. 実践ロードマップと楽観的未来戦略:AI融合による知力解放
AIによる脆弱性探索や自動攻撃といったリスクのみに目を奪われ、技術の導入を躊躇することは最大の機会損失である。正しい「情報最小化」と「ローカル外部脳」の基盤を構築すれば、ディストピア的なAI支配論を克服し、個人が巨大な生産性を手にする「楽観的未来」を切り拓くことができる。
段階的実装ロードマップ
【実装ロードマップの3フェーズ】

[ Phase 1: 情報最小化とデータ収集 ]
  ・自社・ローカルPCからのクリティカルデータ非保持化(クラウド委託)
  ・日常の会話・思考・音声ログ(Circleback等)のローカル(Obsidian等)集積開始
       │
       ▼
[ Phase 2: ローカル外部脳と評価基盤の構築 ]
  ・ローカルデータの自動インデックス化・圧縮・検索環境の整備
  ・AI成果物の自動採点用「自己改善ルーブリック」のローカル策定
  ・外部AIへのコンテキスト自動絞り込み伝送(ハブ機能)の確立
       │
       ▼
[ Phase 3: 自律エージェントの導入とチーム化 ]
  ・dots、Grok Bot、自作LINEハーネス(247等)の投入
  ・24時間365日の業務自動実行(開発・リサーチ・資料作成)体制の完成
-
フェーズ1(情報最小化とデータ収集): 運転免許証、顧客個人情報、決済情報などのクリティカルデータを自社システム内から排除し、高セキュリティなクラウドサービスへ寄託する。同時に、日常の打合せ音声(サークルバック等による録音テキスト化)、思考メモ、成功・失敗体験のすべてをローカル環境(Obsidian等)へストックし始める。
-
フェーズ2(ローカル外部脳と評価基盤の構築): ローカルに溜まった膨大なコンテキストを自動で整理・インデックス化するシステムを整備する。さらに、成果物の品質を担保・向上させるための「自己改善用評価ルーブリック」をローカル内に蓄積する。外部AIを利用する際は、必要な文脈と評価基準のみを自動抽出して安全に渡すハブ構造を確立し、クラウドAIを「使い捨ての実行エンジン」として接続する。
-
フェーズ3(自律エージェントの導入・チーム化): dotsやGrok Bot、自作ローカルハーネス(LINE/Discord連携等)を投入。開発、リサーチ、提案書作成などのタスクを各エージェントへ委任し、人間が寝ている間も168時間(24時間×7日)絶え間なく業務が実行・完結する自動化体制を完成させる。
「人間の独自体験・判断」と「AIの自動実行」の融合(知力的共生モデル)
どれほどAIのモデル性能がコモディティ化(一般化)しようとも、「ユーザー自身の失敗・成功体験」「固有の価値観」「顧客との泥臭い対話履歴」という一次コンテキストは、人間にしか生み出せない究極の差別化要因である。
-
役割の完全分業と心理的解放: 人間は脳のメモリを占有していた未解決タスクや「どうしようもない不安の塊」から解放され、良質なコンテキストの蓄積と最終的な意思決定(価値判断)に100%集中する。実際のコード記述、画面操作、リサーチ、資料化などの泥臭い実務処理はすべて自律型エージェント群に委任する「知力的共生モデル」を確立する。
-
個人・小規模チームの知力解放: 過去の産業革命やルネサンス期と同様、知的作業の限界コストがゼロに近づくことで、個人の知的エネルギーは爆発的に解放される。巨大な組織や何十人もの人間を雇うことなく、個人起業家(ソロプレナー)や極小人数のチームが、巨大企業に匹敵する莫大な価値と革新的サービスを生み出せる時代がすでに到来している。
本レポートの結論
ステルスAI時代における真の防衛術とは、重厚なセキュリティの壁を築いて「データを隠し持つこと」ではない。危険な機密データは極力排除して**「情報を最小化」しつつ、自身の手元に「ローカル外部脳」と「自己改善ルーブリック」を安全に蓄積・構築すること、そしてそれを燃料として「自律型AIエージェント群」**を24時間駆動させることである。この確固たる戦略基盤を確立した者こそが、AIと完全に融合し、時代の主権を握り続けることができる。
引用したサイトなど
junchan-world.comdocs.google.com

その他の関連資料
NotebookLM共有リンク
❤️見てね:🚨土曜 夜8時からのツイキャス

※【購入した人達への編集後記メモ】※
いつ頃、どのタイトルの内容を編集したか❓
コメント